异构计算加速框架-叠前数据处理
异构计算是指采用不同类型的指令集和体系架构的计算单元组成系统的计算方式。相比传统CPU,异构计算可以实现更高的效率和更低的延迟。目前的异构计算引擎主要有图形处理器(GPU,Graphics Processing Unit)、现场可编程门阵列(FPGA,Field Programming Gate Array)、专用集成电路(ASIC)等。
CPU-GPU协同是实现高性能计算的必要条件,称为CPU-GPU异构计算(HC,Heterogeneous Computing)。它通过将应用程序的计算密集型部分卸载到GPU来提供更高的性能,而其余代码仍然在CPU上运行,能智能地结合CPU和GPU的最佳特性以实现高计算增益,旨在将每个应用程序的需求与CPU/GPU架构的优势相匹配,并避免两个处理单元的空闲时间。
1、 GPGPU
通用图形处理器(GPGPU,General Purpose Graphics Processing Unit)最早由NVIDIA公司的Mark J. Harris于2002年提出。基于图形渲染管线的流水线特征,GPU本质上是一个可同时处理多个计算任务的硬件加速器。由于GPU中包含了大量的计算资源,Mark J. Harris自2002年就开始尝试在GPU上做通用并行计算方面的研究。在此阶段,由于架构及编程平台的限制,研究人员采用将目标计算算法转换为图形运算算法的方式,使用GPU来实现通用并行计算需求。
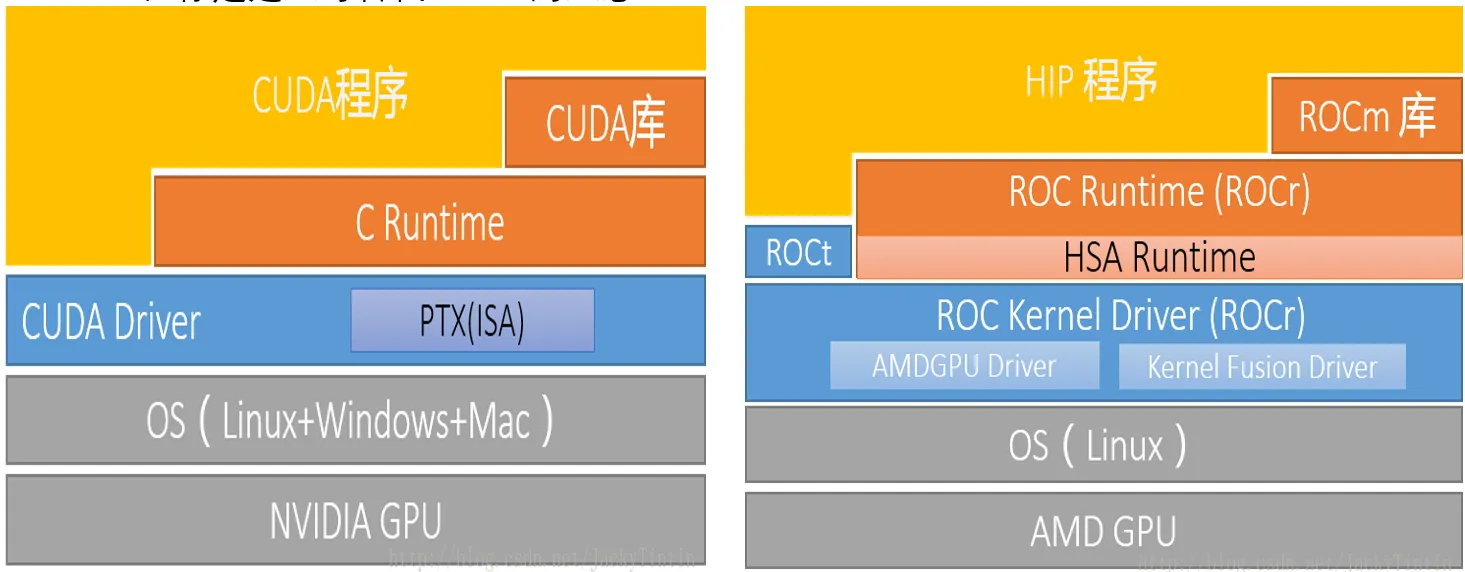
NVIDIA -> CUDA(Compute Unified Device Architecture,计算统一设备架构)编程模型
AMD -> RCOm (Radeon Open Compute, 开源软件栈, 软件平台,运行环境) 编程模型使用的是HIP或者OpenCL
2、NVIDIA CUDA 生态
CUDA是由NVIDIA公司推行的一套并行编程框架,目前只有NVIDIA的GPU支持该框架,其开发语言主要为CUDA C。作为一种GPU的并行开发语言,CUDA的API涉及设备管理、存储管理、数据传输、线程管理、事件管理等功能。CUDA的存储模型主要分为全局存储(global memory)、局部存储(local memory)、共享存储(shared memory)、常量存储(constant memory)和纹理存储(texture memory)等存储类型。不同的存储类型,其存储容量、可见程度、读写速度差异巨大,需要在程序设计中根据各自特点和应用问题的需求合理调配。
CUDA的编程模型和执行模型按照层次结构分层设计。CUDA的执行模型由3个层级组成,最基础的执行单位是线程(thread),多个线程组成一个线程块(block),多个线程块形成线程网格(grid)。CUDA编程模型作为一个异构模型,其中使用了CPU和GPU。在CUDA中,主机(host)指的是CPU及其存储器,设备(device)是指GPU及其存储器。在主机上运行的代码可以管理主机和设备上的内存,还可以启动在设备上执行的内核函数(kernel)。这些内核由许多GPU线程并行执行。
2.1 NVCC编译
CUDA应用程序的源代码由传统的C++主机代码和GPU设备函数混合组成。CUDA编译过程将设备函数与主机代码分开,使用专有的NVIDIA编译器和汇编器编译设备函数,使用可用的C++主机编译器编译主机代码,之后将编译过的GPU函数嵌入到主机对象(object)文件。在链接阶段,向最终生成的可运行二进制文件添加特定的CUDA运行时库函数,如支持远程SPMD过程调用的运行时库函数、显式GPU操作的运行时库函数(如分配GPU内存缓冲区,主机与设备之间的数据传输等)。
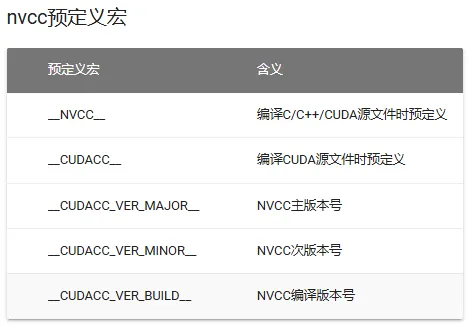
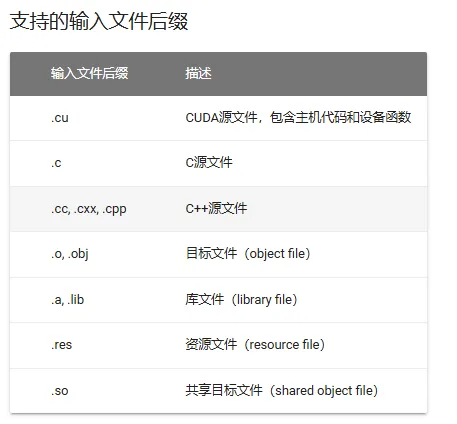
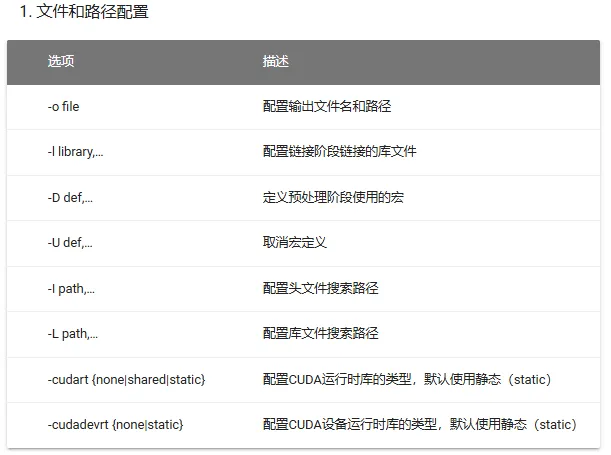
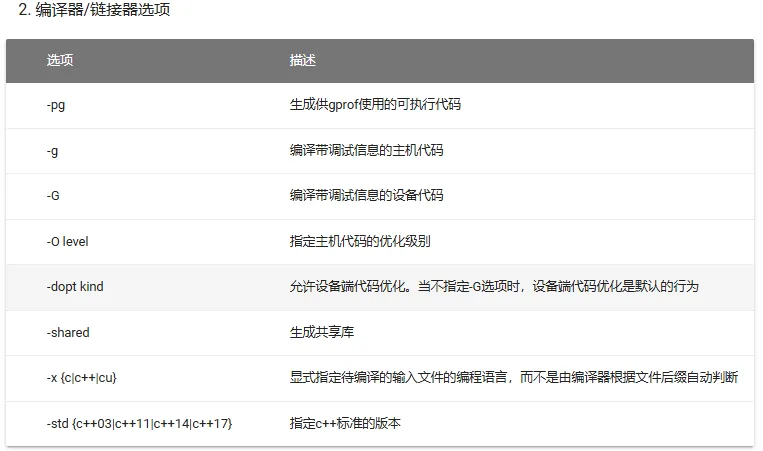
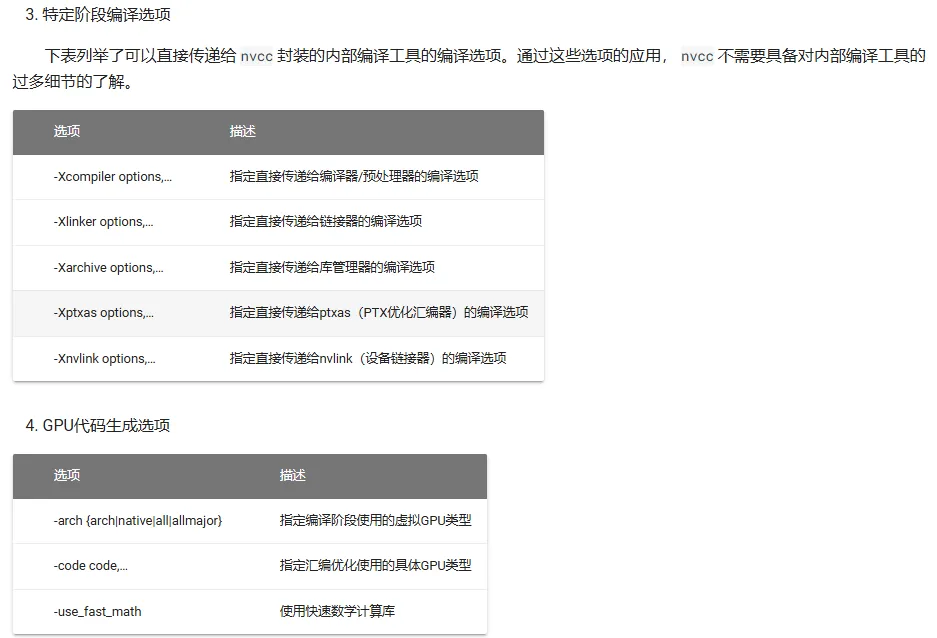
编译过程涉及每个CUDA源文件的拆分、编译、预处理和合并步骤。为了将上述复杂的编译过程向开发人员隐藏,NVIDIA公司设计了CUDA编译器引擎程序nvcc。nvcc接受一系列常规编译器选项,例如宏定义和头文件、函数库路径设置,支持编译过程的组合。所有非CUDA编译步骤都被转发到nvcc支持的主机C++编译器,编译选项到主机C++编译选项的转换也由nvcc自动完成。
2.2 基本参数
2.3、数学库
-
cuBLAS:cuBLAS库提供了基本线性代数子程序(BLAS,Basic Linear Algebra Subprograms)的GPU加速实现。cuBLAS利用针对NVIDIA GPU高度优化的行业标准BLAS API加速AI和HPC应用。cuBLAS库包含用于分批操作、跨多个GPU执行以及混合和低精度执行的扩展。
-
cuTENSOR:cuTENSOR库是第一个由GPU加速的张量线性代数库,提供张量收缩、还原和元素运算。cuTENSOR用于加速深度学习训练和推理、计算机视觉、量子化学和计算物理等领域的应用。
-
cuSPARSE:cuSPARSE库为稀疏矩阵提供了GPU加速的基本线性代数子程序,其功能可用于建立GPU加速的求解器。cuSPARSE被从事机器学习、计算流体力学、地震勘探和计算科学等应用的工程师和科学家广泛使用。
-
cuSOLVER:cuSOLVER库提供了针对NVIDIA GPU高度优化的密集和稀疏因式分解、线性求解器和eigensolvers。cuSOLVER用于加速科学计算和数据科学等不同领域的应用,并拥有针对混合精度张量加速和跨多个GPU执行的扩展。
-
cuFFT:cuFFT库提供了针对NVIDIA GPU高度优化的快速傅里叶变换(FFT,Fast Fourier Transform)实现。cuFFT被用于建立跨学科的商业和研究应用,如深度学习、计算机视觉、计算物理、分子动力学、量子化学以及地震和医学成像,并具有跨多个GPU执行的扩展。
-
cuRAND:cuRAND库是一个随机数发生器的GPU设备端实现。
3、叠前数据加速策略
难点:
- 数据量大;(I/O密集,CPU和GPGPU异步计算)
- 计算量大;(计算密集,GPGPU+MPI协调加速)
计算策略:
- 数据并行:基于MPI算法将不同偏移距或者不同炮数据发到不同CPU;
- 模型并行:将模型切分部署到GPU加速卡上,涉及多GPU之间的大量数据传输,通过RDMA或者NVLINK技术解决;
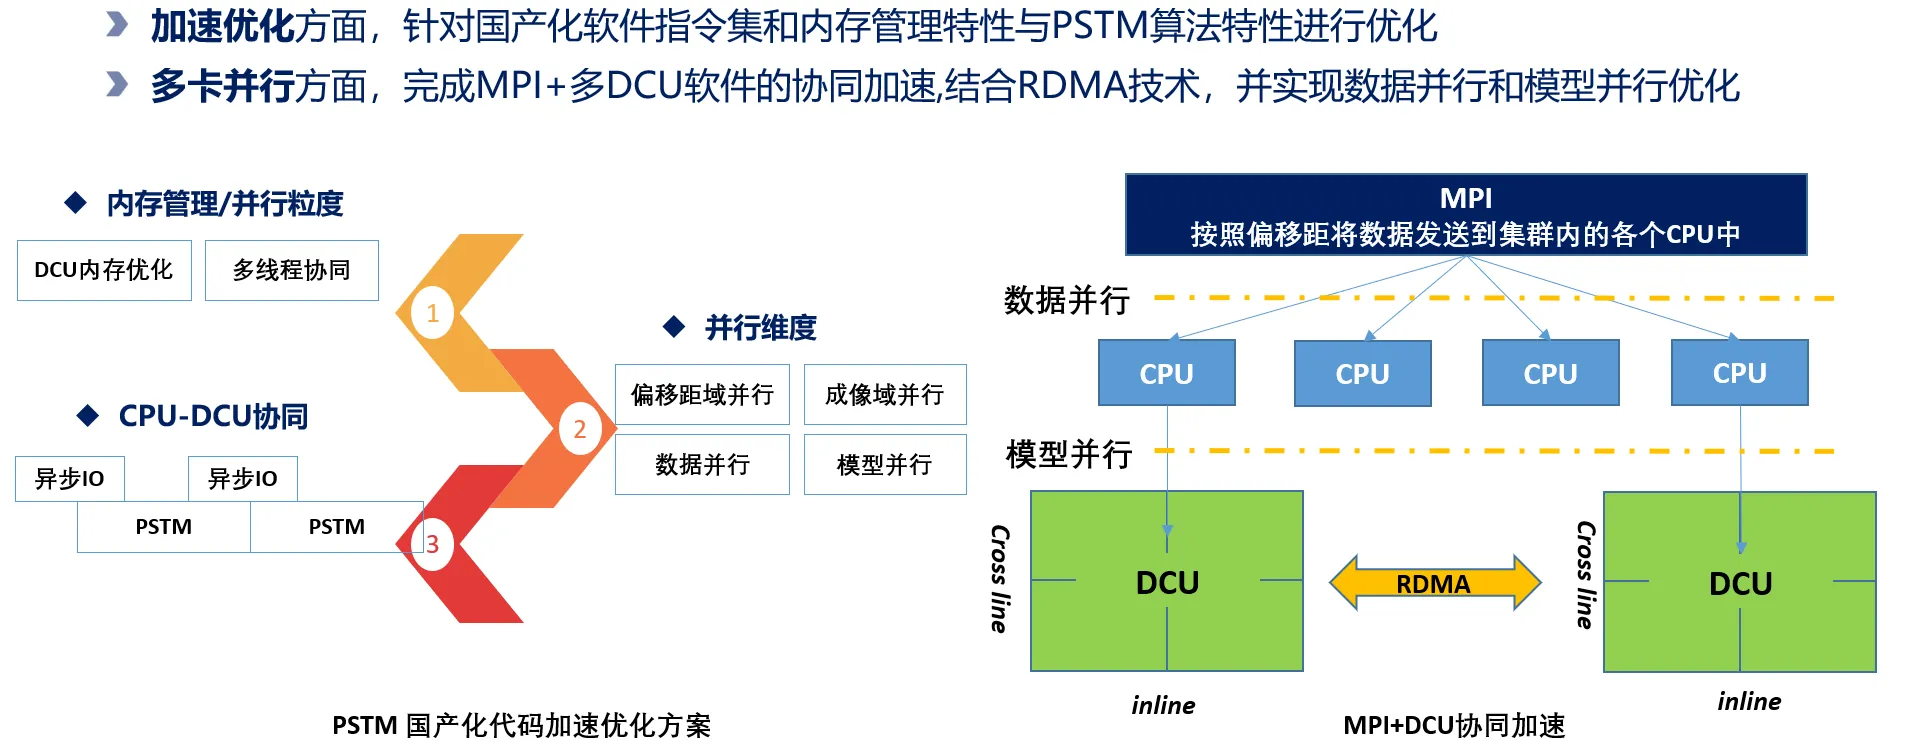
4、具体加速策略(FDTD + FWI)
前提假设(小模型+集群+异构)
- 每个卡能够放下偏移距限制下的小模型,满足反演偏移需要。
- 集群之间通讯需要MPI通讯,GPGPU通过NVLINK或者RDMA计算显卡之间通讯。
- 每个卡通过异步流实现分配的单炮运行。
- 运行的结果通过 MPI_CAST 发送到其他节点。
- 每个节点上采用N个线程,与GPGPU卡个数保持一致,其主要模型和反演结果放在MallocHost中,实现卡调度近似。
总体控制架构
集群控制示意图:
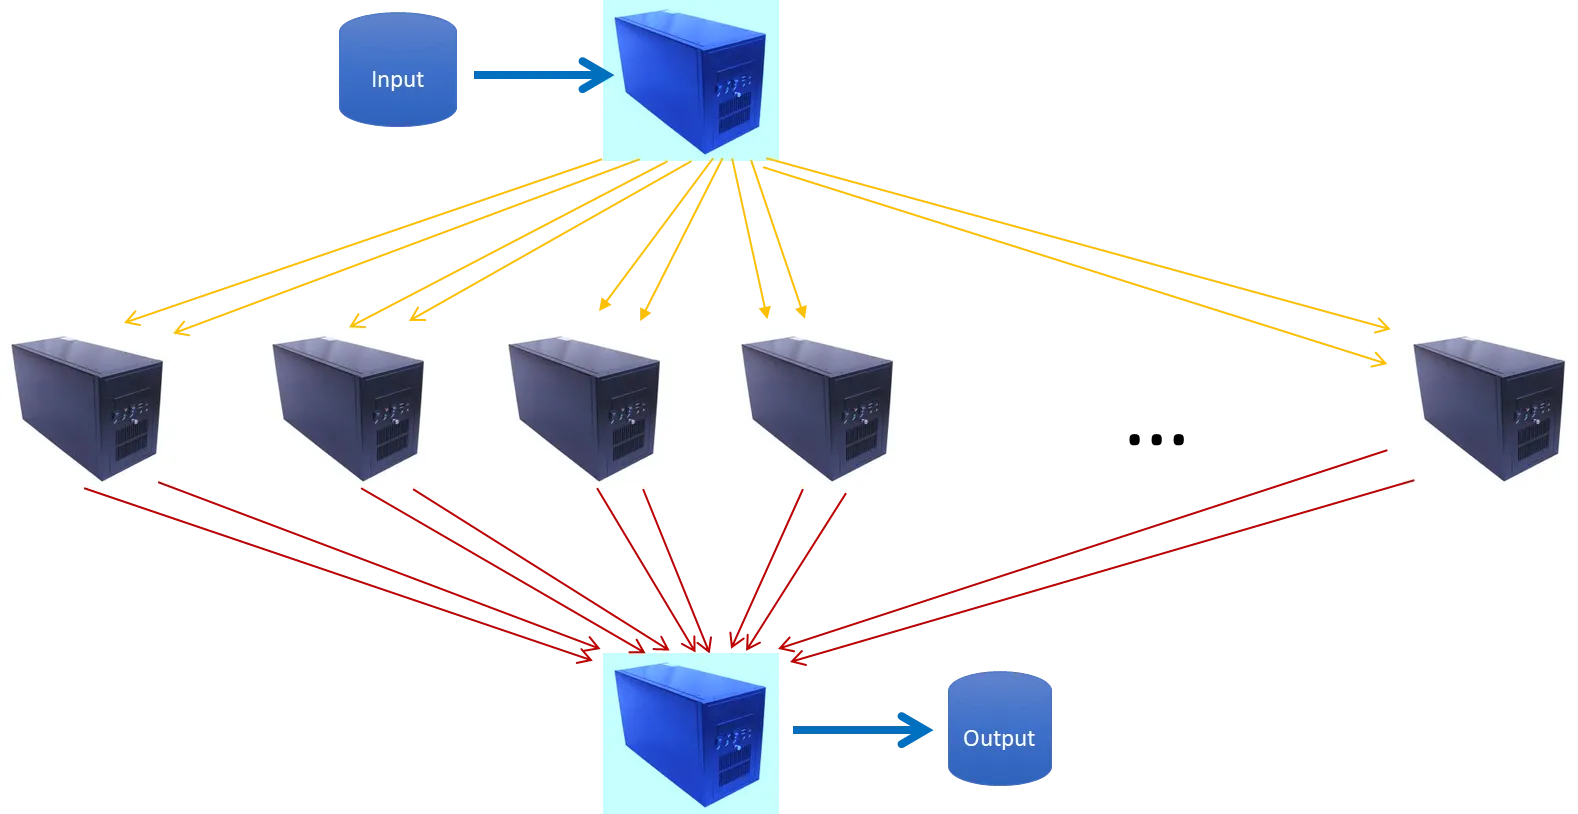
具体展开示意图:
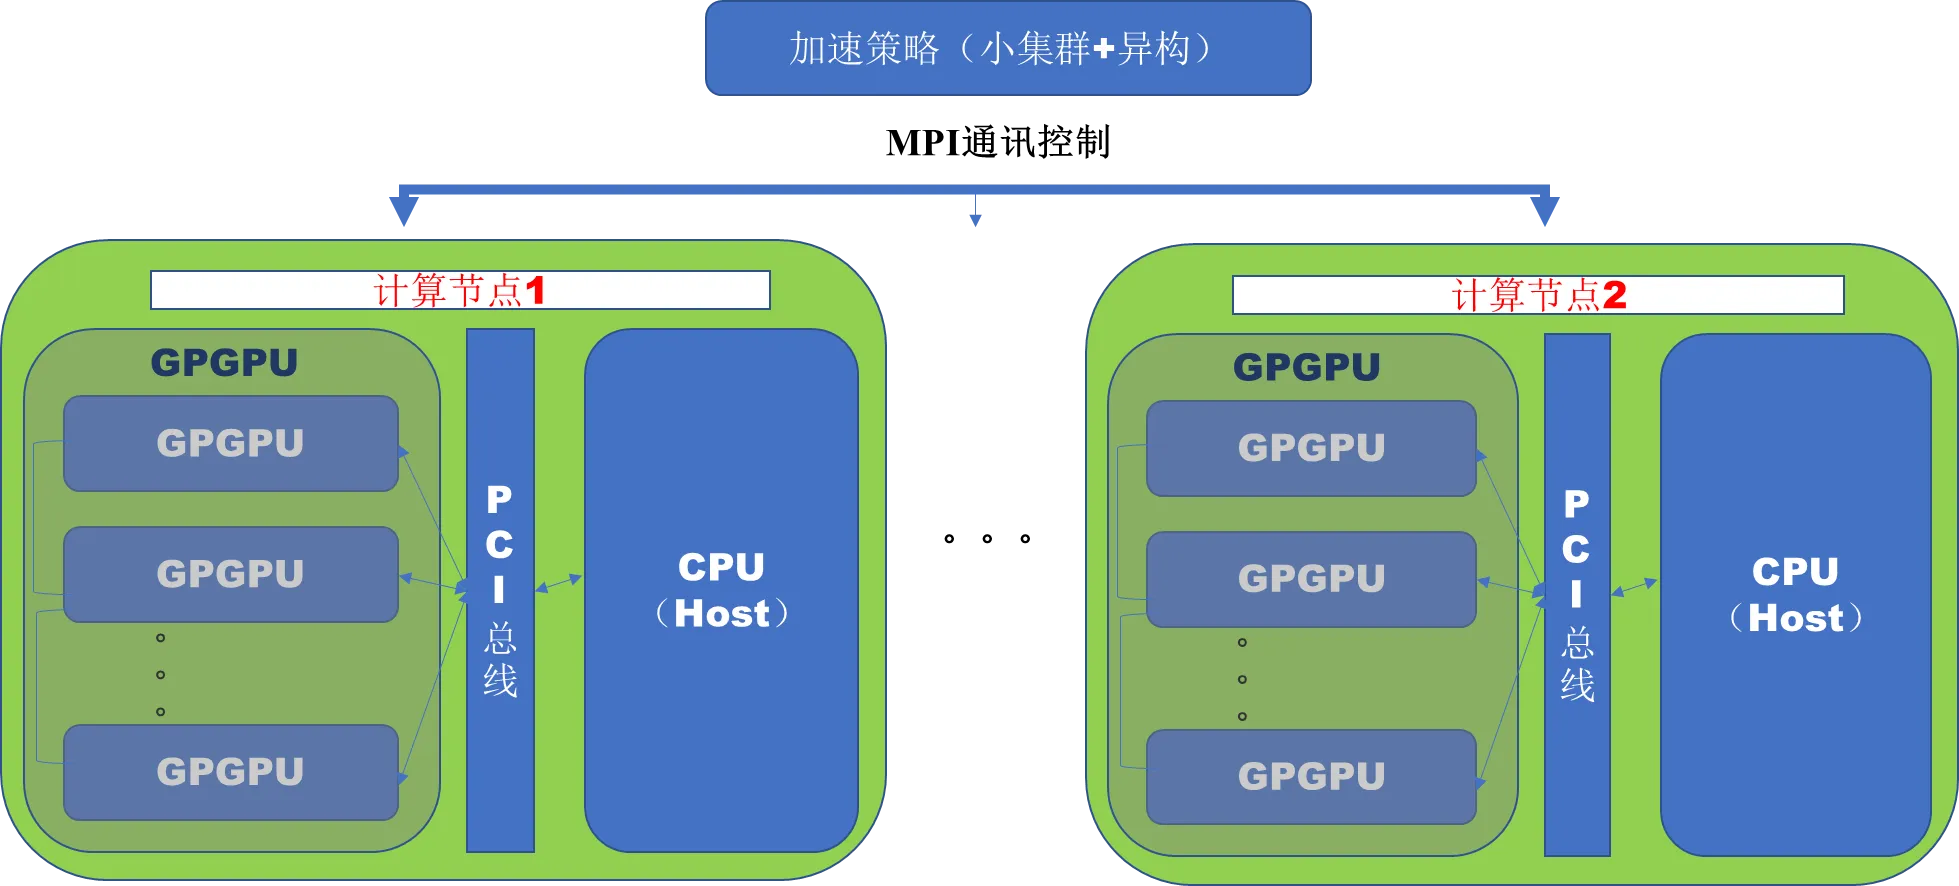
采用MPI进行调度,每个节点分配一个线程,每个线程分配N(N个卡)个CUDA流分别控制N炮,采用cuda流异步通讯的方式。
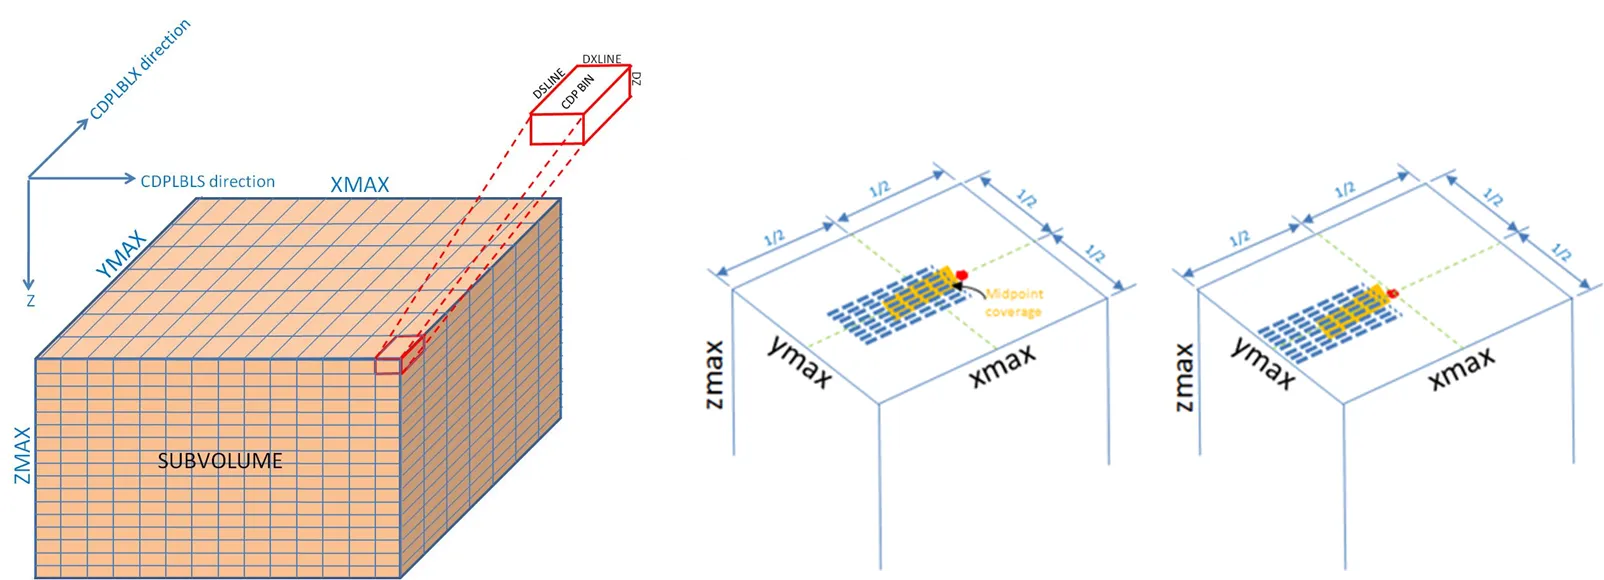
实际资料处理调度原理图
优势:
- 只在一个节点上开辟一个内存占用,有效提高内存使用效率;
- MPI通讯有助于在大型服务器上部署运行。
- 异步传输和cudaMallocHost加速运行效率。
参考
【1】 https://scc.ustc.edu.cn/zlsc/user_doc/html/gpu-computing/gpu-computing.html