333 字
2 分钟
CUDA 原子操作
CUDA 原子操作
1、实例
#include <stdio.h>#include <stdlib.h>#include <math.h>#include <cuda_runtime.h>#define N 12345#define BLOCK 256__global__ void cuda_sum_comp(float *d_data, float *d_data_sum, int n){ int i1 = threadIdx.x + blockIdx.x * blockDim.x; if(i1<n) d_data_sum[0] += d_data[i1];}
__global__ void cuda_sum_atom(float *d_data, float *d_data_sum, int n){ int i1 = threadIdx.x + blockIdx.x * blockDim.x; if(i1<n) atomicAdd(&d_data_sum[0], d_data[i1]);}
int main(void){ float *data, *data_sum; float *d_data, *d_data_sum; data = (float*)malloc(N*sizeof(float)); memset(data,0,N*sizeof(float)); cudaMalloc(&d_data, N*sizeof(float)); cudaMemset(d_data, 0, N*sizeof(float)); data_sum = (float*)malloc(sizeof(float)); memset(data_sum,0,sizeof(float)); cudaMalloc(&d_data_sum, sizeof(float)); cudaMemset(d_data_sum, 0, sizeof(float)); for(int i=0; i<N; i++) data[i] = i-5432; cudaMemcpy(d_data, data, N*sizeof(float), cudaMemcpyHostToDevice); cuda_sum_comp<<<(N+BLOCK-1)/BLOCK, BLOCK>>>(d_data, d_data_sum, N); cudaMemcpy(data_sum, d_data_sum, sizeof(float), cudaMemcpyDeviceToHost); printf("CUDA_compute:sum = %f\n", data_sum[0]); memset(data_sum,0,sizeof(float));cudaMemset(d_data_sum, 0, sizeof(float)); cuda_sum_atom<<<(N+BLOCK-1)/BLOCK, BLOCK>>>(d_data, d_data_sum, N); cudaMemcpy(data_sum, d_data_sum, sizeof(float), cudaMemcpyDeviceToHost); printf("CUDA_atom:sum = %f\n", data_sum[0]); free(data); free(data_sum); cudaFree(d_data); cudaFree(d_data_sum);}运行结果:
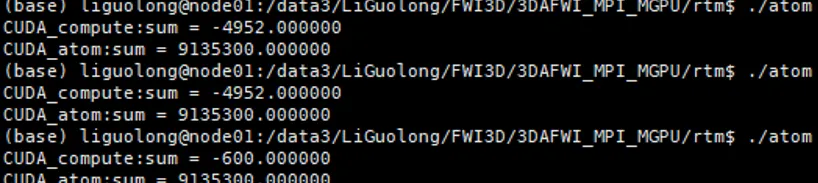
原子操作列表
加法:T atomicAdd(T *address, T val); 功能:new = old + val。
减法:T atomicSub(T *address, T val); 功能:new = old - val。
交换:T atomicExch(T *address, T val); 功能:new = val。
最小值:T atomicMin(T *address, T val); 功能:new = (old < val) ? old : val。
最大值:T atomicMax(T *address, T val); 功能:new = (old > val) ? old : val。
自增:T atomicInc(T *address, T val); 功能:new = (old >= val) ? 0 : (old + 1)。
自减:T atomicDec(T *address, T val); 功能:new = ((old == 0) || (old > val)) ? val : (old - 1)。
比较-交换(Compare And Swap):T atomicCAS(T *address, T compare, T val); 功能:new = (old == compare) ? val : old。
按位与:T atomicAnd(T *address, T val); 功能:new = old & val。
按位或:T atomicOr(T *address, T val); 功能:new = old | val。
按位异或:T atomicXor(T *address, T val);